上一篇,我把 SpeakFlow 的核心训练做成了不依赖实时模型的流程:先独立练习,针对错误短练,再换材料检验。材料、答案和反馈都有版本,练过什么也能回看。
这次继续往下做,我把注意力放到了进入练习之前。
用户打开一个学习工具,可能还没开始学,就得先做几道选择题:今天点哪个入口?上次没弄明白的内容在哪里?只有一小段时间,做哪项合适?功能逐渐齐全以后,这些问题仍然需要产品回答。
所以,这一轮我想先把两件事接起来:让人知道今天从哪里开始,再留下他自己尝试过的证据。
今日页面要能交代清楚
我给 SpeakFlow 加了一条“今日”路线。页面要回答四个具体问题:练什么、为什么练、预计花多久、下一步点哪里。到了复习时间的缺口,也能从这条路线接着练。
这里的取舍很小,却影响整个入口。这次首页先组织好一段可以开始的任务,把顺序交代在进入练习之前。想深入的人仍然需要材料和记录,但刚打开页面的人,至少应当有一个明确的起点。
预计时长在这里是安排练习的参考。它还没有经过真实使用者的耗时验证,不能当成“几分钟就能学会”的承诺。
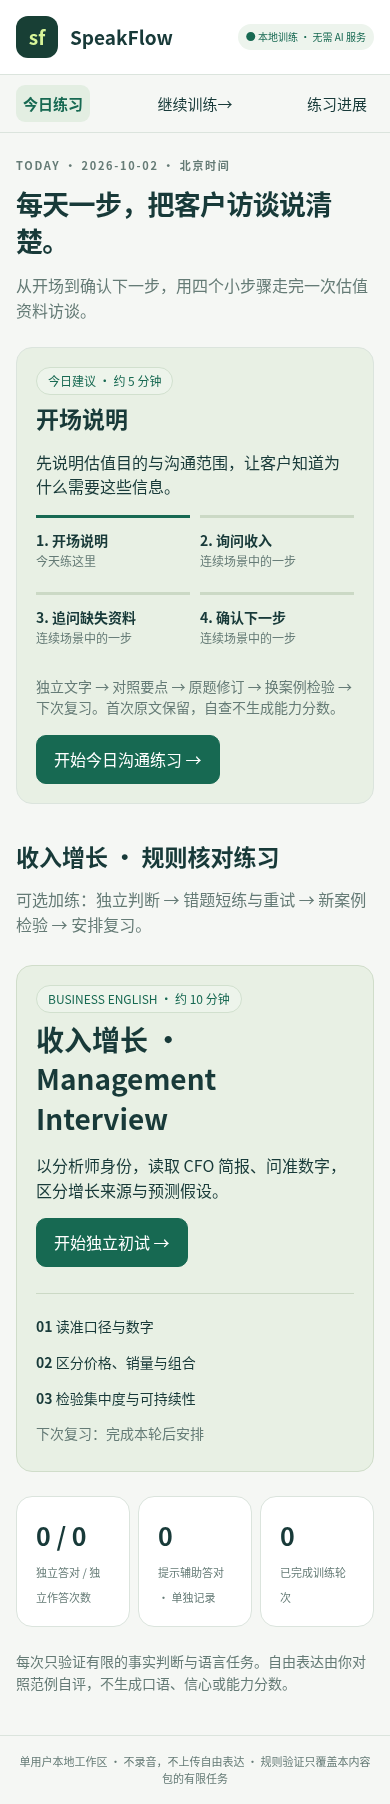
用一次客户沟通串起练习
这轮内容围绕一个具体场景展开:为估值项目向客户收集资料。练习按沟通顺序分成四步:开场说明目的、询问收入信息、补齐缺失资料、商量后续安排。
这几步放在一起,练习的重点就更清楚了。问收入时,除了句子是否通顺,还得交代是哪几个财年;追问缺失资料时,要让对方知道为什么需要;约下一次沟通时,时间尚未确认,就不该写成双方已经同意。
这些细节比多放几个生词更接近任务本身。同样一句客气的英文,放错位置、遗漏范围,仍可能让对方不知道该准备什么。
当前这组场景有 12 个经过核对的变体,仍沿用带版本的内容包。英文自然度、财年范围、资料用途、周次和未确认约会的措辞,都在这次检查之内。覆盖范围依然有限,系统也只能在这些已准备好的材料里组织练习。
先写自己的,再看示范
这一轮最重要的顺序调整,是先让使用者独立写一版。
提交前,示范和检查清单不会提前出现;提交后,最初那版会保留下来,再进入对照和修改。这样回看时,才分得清哪些表达是自己组织的,哪些是在看到提示之后补上的。
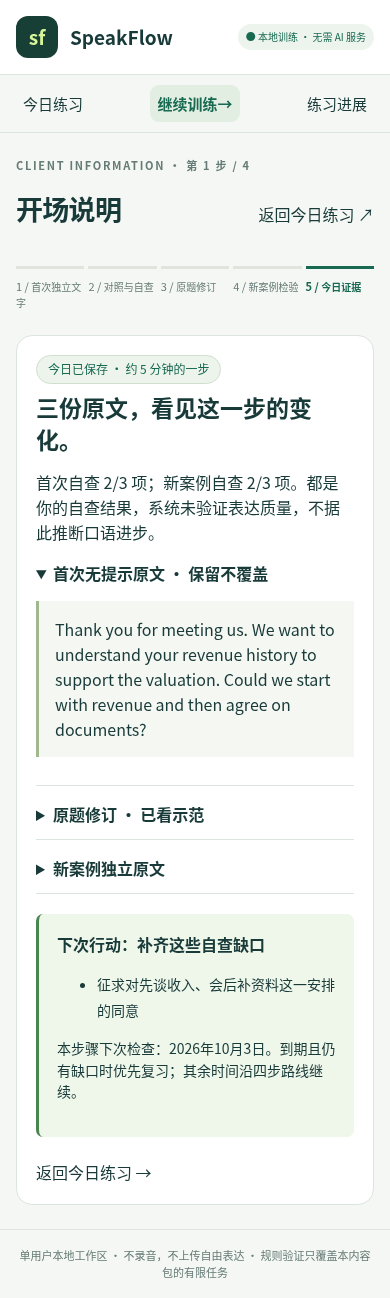
我不想让一次漂亮的修改,覆盖掉最有价值的那条记录:没有帮助的时候,自己究竟写出了什么。
比如最初只问了收入数字,看过清单后才补上财年范围。两版都留下,就能看见“范围不清”是这次要继续练的地方。若只保存最后一版,页面虽然整齐了,下一次练习却少了一条依据。这是记录方式能提供的线索,具体表达是否合适,仍需要人来判断。
接下来还要区分两种动作。一种是回到原情境,把刚才那段话改好;另一种是换一个新情境,再独立尝试并自查。前者能看见修改过程,后者多保留了一次新材料下的尝试,记录里把它们分开。
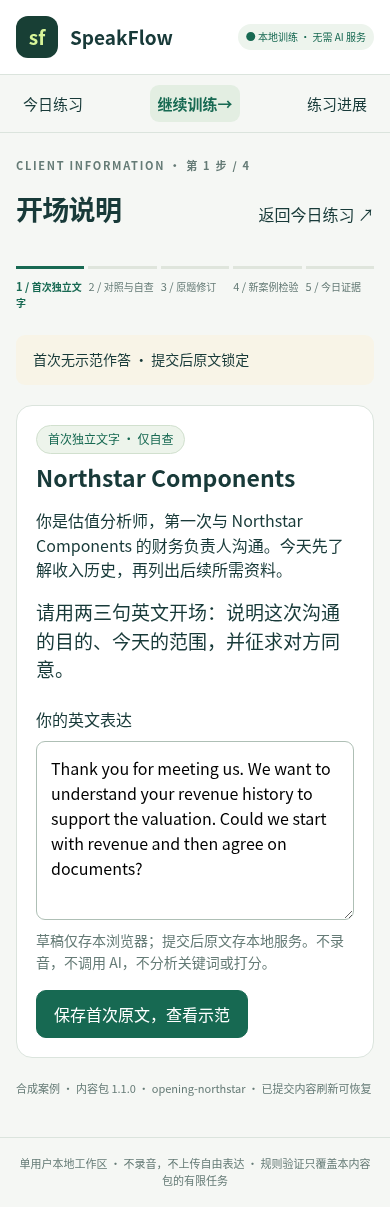
这里仍然没有自动判断自由表达水平。当前留下的是书面作答、修改和自查记录。写得更完整,不等于已经能在真实对话中流畅说出来;新情境下自查通过,也不能直接算成能力认证。
明天还能从这里接下去
练习中断后,重新打开却只剩一个空输入框,很容易让“再练一次”变成“再填一次”。这版给尚未提交的书面回答补了草稿恢复,并把到期缺口接回复习。
草稿恢复有明确范围:目前只限同一个浏览器、同一个访问端口,并没有跨设备同步。日期则统一按北京时间处理,避免临近午夜时,页面与服务端对“今天”各有一套判断。旧记录继续保留,新的路线不需要靠清空过去重新开始。
这些细节已经做了工程检查,包括草稿、练习流程、日期边界和手机窄屏。本地的 33 项单元与 API 测试、11 项浏览器测试通过,内容包和脚本检查也通过了。
测试能帮助确认程序按预期运行。使用者是否更容易开始、隔几天还能不能独立完成、愿不愿意回来练,仍然需要真实使用来回答。
这一轮给我的提醒是,学习工具得替使用者处理一部分安排:今天先做什么,做完以后去哪里,上次留下的问题何时再看。同时,也要给独立尝试留出位置,别太早把答案摆在眼前。
我想继续沿着这条线打磨 SpeakFlow:让入口更清楚,让练习记录足够诚实。先把一次练习接到下一次,再观察它究竟有没有帮上忙。
浩哥AI实验室