做 AI 教练 先让它不必每次都调用 AI
SpeakFlow 构建记录 02 · 浩哥AI实验室
上一篇,我给 SpeakFlow 留了一个问题:AI 打完分,用户接下来怎么练?这次我把那条练习流程做进了代码,也改了一个更底层的选择:先让核心训练不依赖实时模型。
原因很实际。每次出题、判断和点评都临时调用 AI,结果是否稳定、每轮要花多少钱,就会跟着使用量一起变成问题。而用户究竟愿不愿意回来练,还需要验证。
先把一个场景做扎实
我保留了一个很窄的任务:用英语读懂一家公司的收入增长,再问清楚增长来自哪里。当前内容包里有三家合成公司、六项技能、十八道题,题型包括选择、数字提取和句子排列。
AI 可以参与开发和内容编写,但用户开始练习后,系统读取的是带版本的题目、答案和反馈。同一道题为什么判错,能回到材料和规则里核对。内容仍需要专业审校,程序校验通过不能替它把关。
这相当于先把练习用的材料整理好,再交给程序执行。模型擅长帮人写初稿、补变体,却不需要在每次点击后重新组织一遍标准答案。代价也很明确:题库覆盖不到的表达,系统就不能假装已经理解。
比如材料说,过去三年收入从 1.2 亿美元增长到 1.68 亿美元。若选择“明年会增长 40%”,反馈就指出:把历史累计增长直接外推到明年,缺少证据。比起一个总分,这句话更清楚地告诉人下一步该改什么。
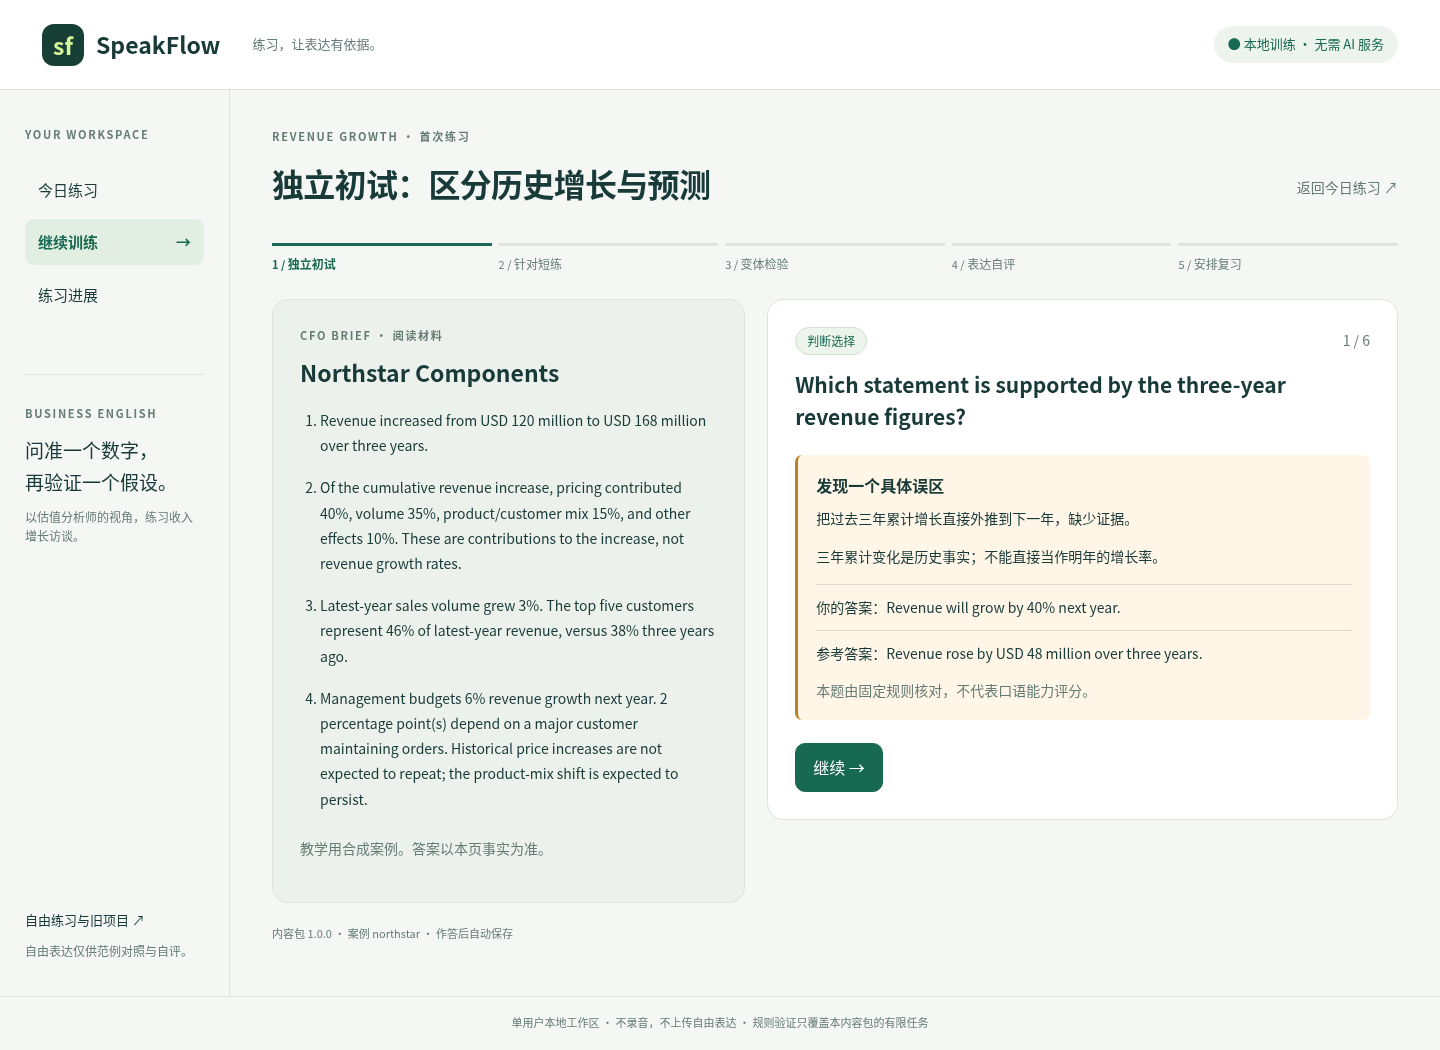
图 1 实际测试中的错误反馈。原始测试界面,数据为教学合成案例;固定规则只核对本题,不作口语能力评分。
答完以后 还有一次不带提示的检验
这次补上的流程是:先独立做一轮,留下原始答案;根据具体错误做针对短练;再换一家公司和一组数字,把提示撤掉,单独记录结果。最后进行表达自评,安排下一次复习。
上一篇里,Retry 入口已经存在,但新一轮未必围绕刚才的错误展开。这次把错误和下一段练习接起来,使用者才不必看完一大段点评,再自己猜应该重练哪里。练习记录也要分清,哪些答案是在提示之后完成的。
换公司这一步很重要。刚看过参考答案,马上照着改对,只能说明这一次跟上了。换一组材料再做,才多了一条判断依据。当然,一轮换题答对,离证明长期学会还有距离。
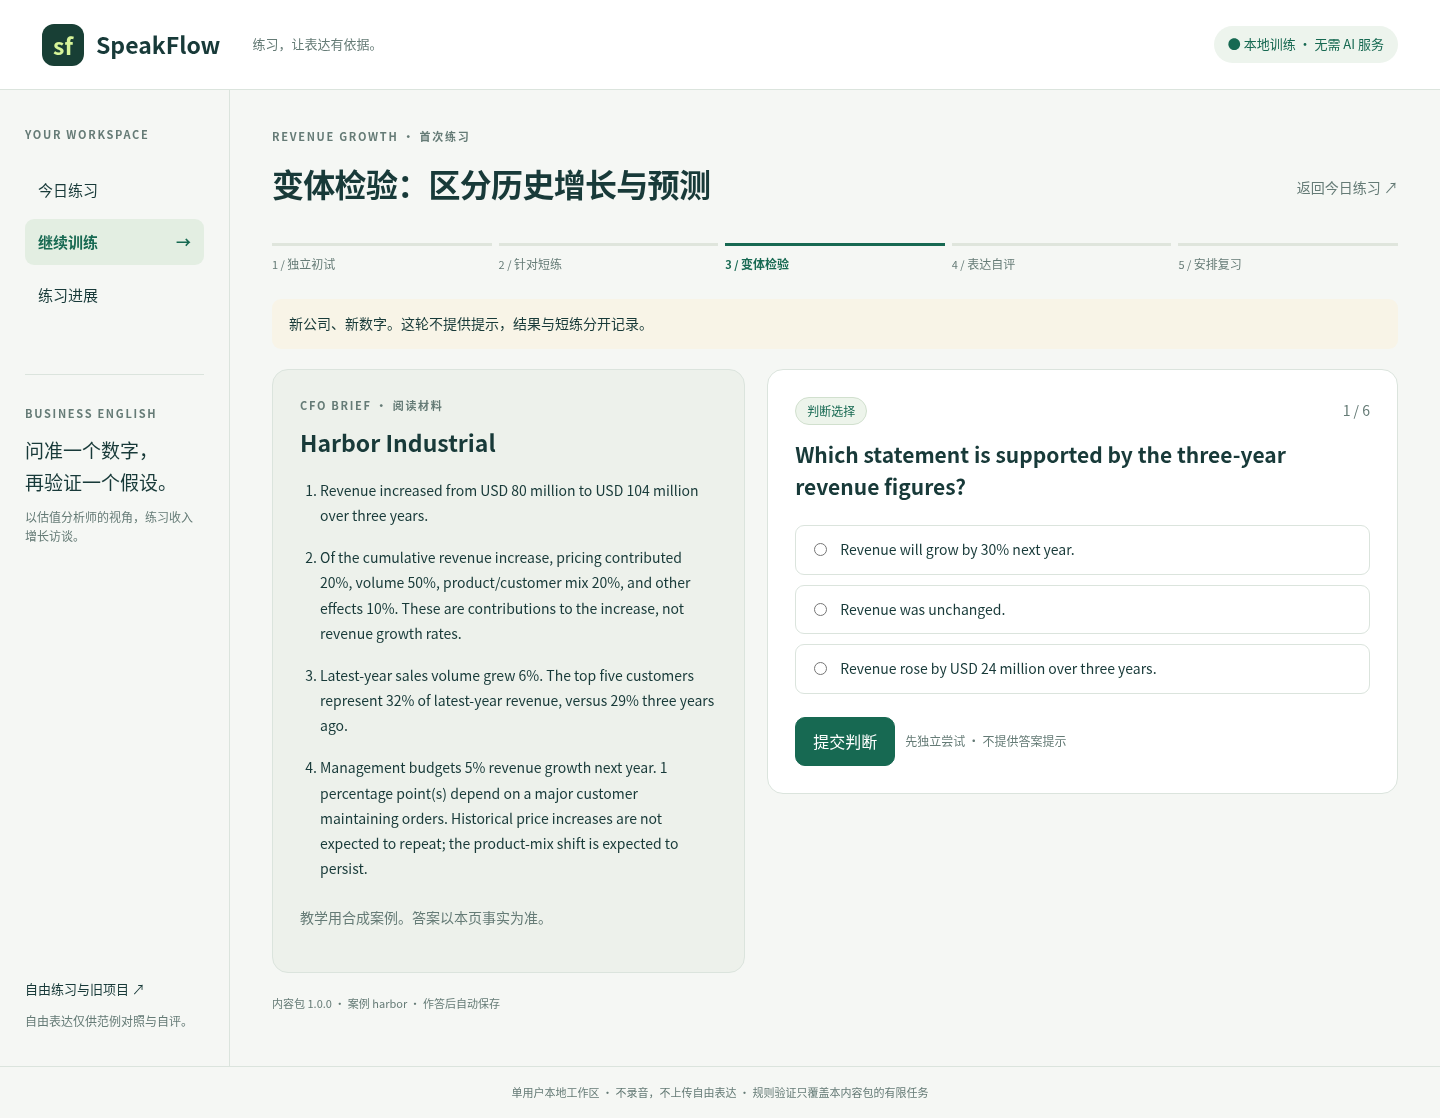
图 2 换成 Harbor Industrial 后的独立检验。公司和数字已变,提交前不提供答案提示;结果与短练分开记录。
变化也有边界。系统只在有效的内容变体内选择题目,答案和反馈仍要对应当前材料。我不想用随机数字、随机点评制造“每次都很聪明”的感觉。这样做少了一些自由,但出了问题更容易定位。
自由表达暂时保留给用户对照范例、自我检查。系统没有听过你的发音,就不该给出口语分;没有验证你能独立说出来,也不该把一句自评变成能力认证。
让练习记录经得起刷新和重试
页面能走完,只是工程检查的开头。做了一半刷新,答案还在不在?连续点两次提交,会不会记成两次练习?同时开两个页面,旧页面会不会覆盖新进度?这些都直接影响训练记录是否可信。
这版补了刷新恢复、重复提交保护、过期页面拒绝写入和损坏存储保护。新训练记录与旧项目数据分开保存,还记录内容版本、题目快照校验值、所用变体、答案、反馈、提示和修改过程,便于回看当时究竟练了什么。
同时收紧了静态文件的可访问范围,限制本地服务接受的访问主机名,并修改了语音合成调用的参数处理。测试没有接入付费 AI,也没有验证真实录音、语音识别和语音合成服务。安全修正和真实服务可用,是两件需要分别检查的事。
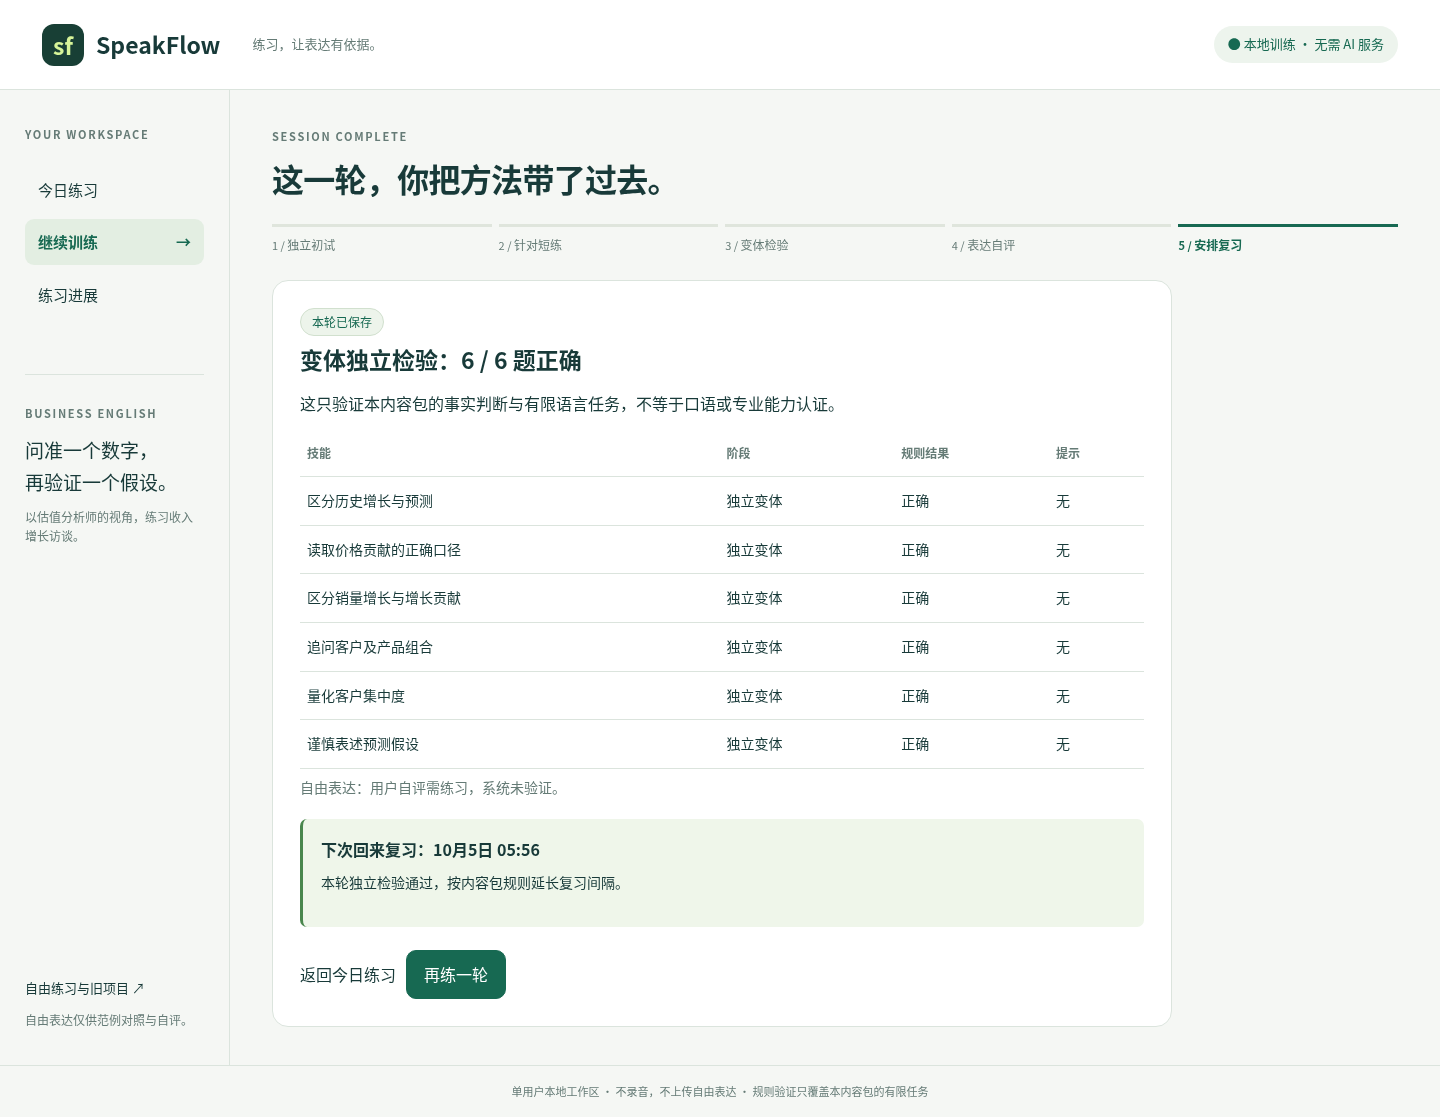
图 3 完成页保留了自由表达的自评边界,并给出下次复习日期。日期是应用内安排,当前没有后台通知。
提交后的持续集成已经通过,覆盖单元、API 和浏览器端到端测试,内容与语法检查也通过了。这些检查证明的是已覆盖的程序行为,真实使用时是否顺手,还需要另外观察。
省下模型调用 还没有回答需求问题
核心训练不调用实时模型,意味着这条路径不会随练习次数产生模型推理费用。但内容编写、专业审校、软件维护和未来托管仍然要投入,暂时也没有收入或学习效果的数据。
这个取舍让我可以把两个问题拆开检查:先看一条稳定的训练流程有没有人需要,再看哪些环节值得为实时模型付费。假如固定材料就足以帮助完成某个任务,先把它用好;遇到规则确实处理不了的开放问题,再增加相应能力。
现在它还是单用户、单进程的本地原型,没有多人账户体系。接下来真正值得观察的,是使用者在哪一步卡住、隔一段时间能否独立完成、会不会回来练第二次。
如果大家练完一次就离开,继续增加模型和题目可能并没有碰到真正的问题。材料是否贴近工作,反馈是否看得懂,十分钟之后有没有留下可复用的方法,都比功能数量更值得追问。这些目前仍是待检验的问题。
如果你也在做 AI 学习工具,可以先选一个小任务:把材料、答案依据、典型错误和下一步练习写清楚,再决定哪里需要实时 AI。这次改完,我至少有了一条能保存证据、能重复检查的训练流程。至于它有没有用,还要交给真实使用来回答。