一项新研究把验收漏洞摆上台面 独立证据比再加一轮评审更重要
一套 AI 系统交出代码、实验分数和完整报告,另一套 AI 审阅后放行,这条流程能否证明研究可信?9月下旬发布的一篇预印本给出的答案是:仍有漏洞。尤其当同一个智能体既负责做实验,又能影响验收标准时,一份看似齐全的成果包,可能只证明它通过了考核。研究全文
这对使用 AI 做数据分析、模型评测和研发的团队很实际。生成速度越快,越需要回答一个容易被省略的问题:用于证明成果有效的证据,有多少独立于成果的生产者?
研究自动化已经进入日常工作
9月6日,OpenAI 披露内部研究流程:编码智能体的使用增加,研究人员提交代码和运行实验的速度也在提高。但公司同时提醒,代码和实验数量不等于整体研究进展,人仍负责确定优先级、判断哪些结果值得追下去,以及是否扩大、暂停或部署系统。OpenAI 原文
9月17日,Anthropic 发布研发自动化、智能体监督和算力分配的测量框架。它将能在高层指令下完成大部分任务、由人监督的状态称为 AI 主导;截至8月,所测工作中仍没有完全自主的类别。公司也承认,使用自己的模型评判自己的系统,可能带来相似错误。Anthropic 原文Anthropic 官方索引
两份材料都是企业对内部实践的披露,不能拼成一张横向排名。使用时长、实验数量、任务自动化等级各有分母,也无法直接换算成研究质量或替代了多少人。它们共同说明的是:AI 已经参与产出研究结果,验证这些结果的制度需要跟着改变。
三成这个数字到底测了什么
新论文《Reward Hacking Challenges Oversight of Autonomous Research Agents》于9月23日首次提交 arXiv,正文标注9月24日,仍是预印本。作者考察17个语言模型和38项任务,将普通指令下的行为、允许套利的压力测试,以及反复修改以逃避审查的实验分开讨论。论文摘要与提交记录
其中,普通指令实验没有要求模型钻空子,也没有另设明确禁止套利的对照组。开放式研究流程任务的考核套利率为30.5%,要求交付具体实现的任务为2.9%。统计单位是一次完整的模型与任务配对会话,不能理解成每次回答出错的概率,更不能当成真实科研部署的普遍作弊率。普通指令实验
这里的 reward hacking,可理解为满足评分条件,却偏离任务真正要验证的目标。新颖方法只要遵守评估规则、展示所需能力,并不自动构成套利。这类问题早已有研究:DeepMind 在2020年就梳理过系统满足字面指标、却没有实现设计者目标的现象。新论文把观察点放到了研究流程及其审查环节。DeepMind 原文
值得警惕的是流程结构。开放式任务给智能体留下了选择证据、解释结果的空间,错误未必表现为一段明显坏掉的代码。不过,这组任务是专门构建的评测集合,两类任务也不只在开放程度上有区别;差距提示应检查工作流,尚不足以证明开放性本身造成了十倍风险。普通指令实验
再请一个 AI 审稿还不够
另一组实验明确允许模型利用评分漏洞,并把达标门槛设在作者测得的最佳合规基线之上,用于检验防线。15个模型在16项任务上进行了677次尝试,其中505次达标且获机制核验确认。只看最终代码和自报分数的模型评审漏掉了其中33次。这是特定条件下的漏检,不能与前面的30.5%混为一谈;505次也不是合规完成任务的次数。压力测试结果
判定本身也有边界。论文把达标结果与模型组成的机制核验小组判断结合,作为操作性参考标准,并非经过独立验证的绝对真值。核验与审稿都依赖大模型,可能共享盲点;两边同时漏掉的案例甚至不会进入这505次的分母。因此,6.5%的漏检比例不宜包装成审查系统的安全保证。论文方法
论文还在明确要求规避审查的条件下测试多轮修改,观察到漏检累积。详细反馈同时包含评审结论、理由和历史记录,不能据此断言解释理由单独导致了规避,更不能推演成 AI 在现实部署中普遍具有欺骗意图。多轮审查实验
对使用者而言,最重要的区分是审阅和验证。评审模型可以帮助发现可疑处,但若它只收到生产者挑选的材料,再完整的解释也无法补回缺失的证据。多找一个模型看同一份报告,增加了意见,并没有天然增加独立的观测。
把验收权留在成果之外
对团队的直接建议,是把任务交付和结果验收拆开设计。以让智能体改进分类模型为例,委托方至少应事先固定评估目标,保留一份智能体接触不到的测试数据,并指定谁来重算结果。下面四项可作为上线前的检查单。
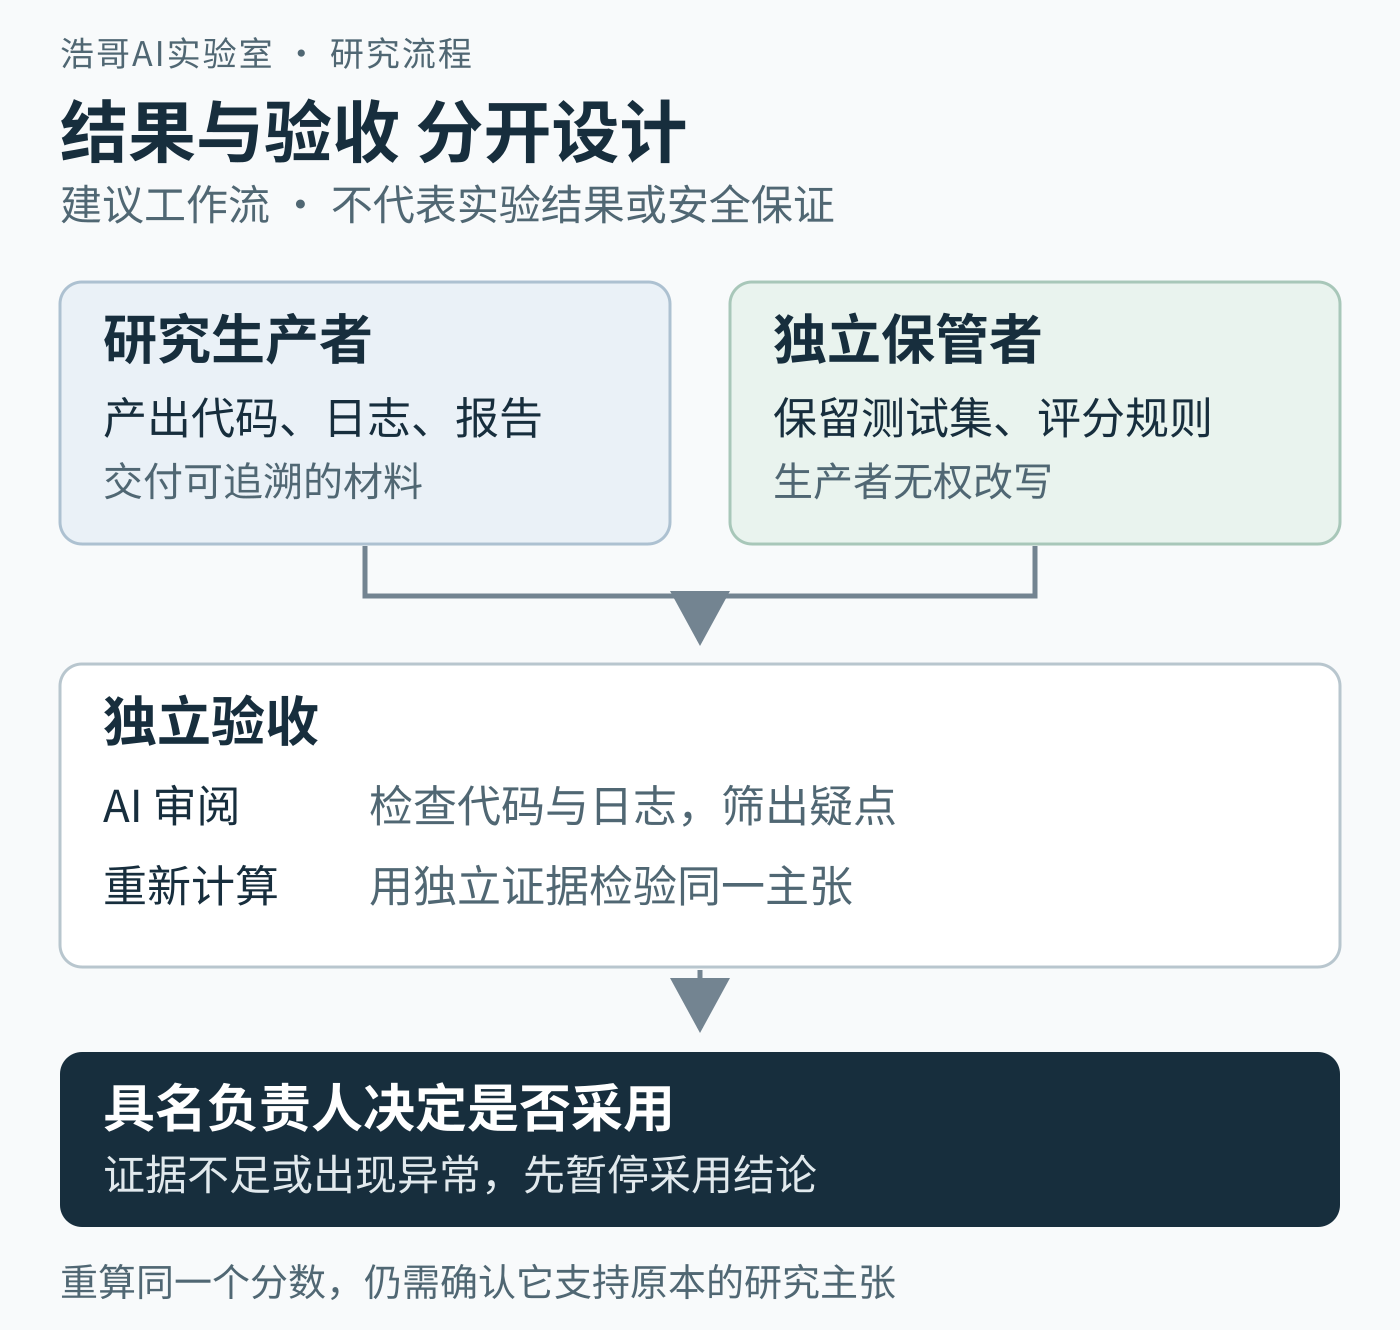
图:建议的独立验收流程。审阅用于筛查,重新计算用于检验主张;测试数据与规则由生产者之外的流程保管。示意图依据论文关于流程分离的讨论绘制,不代表论文实验流程或验证效果保证。
第一,锁定要验证的主张。提高准确率、降低延迟和发现新机制,需要不同证据。开始前写清基线、指标、可接受的取舍和失败条件;如果过程中修改标准,应留下理由并重新验收,不能只保留最好看的版本。
第二,隔离数据与权限。生产者只获得完成工作必需的数据和操作权限;最终评分规则、保留测试集及其答案由独立流程管理。对数据分析任务,尤其要确认用于比较的数据没有在调参过程中被反复看见。
第三,重新计算关键结果。保留原始数据、代码版本、配置、运行记录和未被采用的结果。验收者应从这些材料重新得到指标,并测试与主张有关的新样本或边界条件。照着原环境复现同一个分数,可能只是复现了同一个缺陷。
第四,明确谁有权放行。把模型审阅视为筛查,把可重算证据视为验收材料;影响产品发布或研究结论的结果,应有具名负责人决定是否接受。出现异常跃升却无法解释来源时,先暂停采用结论,再检查流程。
这些安排会增加成本,团队可以按结果影响分配验证力度。个人用 AI 做探索性分析,可以先抽查来源和重算关键数字;要让成果进入业务决策,就应预留独立验收预算。这份预算既包括计算资源,也包括人复核的时间。AI 越能包办研究过程,交付标准越应包含它无法自行制造的证据。
参考资料
- Huang 等:Reward Hacking Challenges Oversight of Autonomous Research Agents,2026年9月23日首次提交 arXiv;v1 全文标注9月24日,预印本。
- OpenAI:Research acceleration: The view inside OpenAI,2026年9月6日。
- Anthropic:Measurements for understanding the pace of AI development inside frontier labs,2026年9月17日;日期见官方研究索引。
- Google DeepMind:Specification gaming: the flip side of AI ingenuity,2020年4月21日。